ラベル マクロ の投稿を表示しています。 すべての投稿を表示

2017年3月10日金曜日

データの抽出条件をIF文のように利用する方法

今回は主にレポーティングツールを利用する際に直面する問題について
対処法の一例をご紹介したいと思います。


抽出条件を変えるだけで複数のプログラム、レポートをまとめる事ができるが、
環境や条件などの理由から、SASのマクロ機能やストアドプロシージャなどが利用できない!
というケースが意外とよくあります。

・使用するレポーティングツールでは、ストアドプロシージャが使用できない。
・SASのマクロを使える人がいないため、今後のメンテナンスを考えて使わないでください。

といったケースが、経験上ありました。


例えば、以下のようなケースが該当します。

店舗を指定して売上を出力するレポートがあります。
そのレポートには以下の抽出条件があります。

    where TENPO = "店舗"
        and YYYYMM = "年月"
※斜体は実行時に入力するパラメータとします。

店舗の条件を削除すれば、全ての店舗情報が取得できる!と考えることができます。
実は、ここで以下の問題が起きます。

  SASのマクロやストアドプロシージャを利用せず、上記の抽出を行わないようにしてください。
  条件には外部からパラメータとして、任意の数字文字が与えられるとします。
  また、データにはあらかじめ全店を集計したレコードは存在しないとします。

難しく書きました。
この問題はSASのマクロを利用すれば以下のように簡単にかけます。

  ・全店か、支店の条件かを判断するフラグ(&ZENTEN)を用意して
    以下のようなプログラムを記載すれば対処できます。

  where
    %if(&ZENTEN = 0) %then %do;
      TENPO = "店舗" and
    %end;
  YYYYMM = "年月"


今回の問題は、マクロを使用せずに行ってください。というものです。
ストアドプロシージャ、SASのマクロ機能が利用できれば簡単に回避できる問題も
利用できなくなるだけで意外と頭を悩ませるものです。


回答例
  ・全店か、支店の条件かを判断するフラグを用意して、下記のようなプログラムを記載します。

where
  ( (全店フラグ = 1                               ) or
    (全店フラグ = 0 and TENPO = "店舗") ) and
  YYYYMM = "年月"

全店フラグが1の場合、全店を取得する場合は店舗の条件を無視したい。
逆に全店フラグが0の場合、店舗を取得する場合は店舗の条件を適応したい。
その為上記のような記載方法になっています。

・全店フラグに1を入れて実行した場合、実行される場合の条件式は以下のようになります。

  ( (1 = 1                               ) or
    (1 = 0 and TENPO = "店舗") )

つまり

  ( (真                               ) or    真の条件のみなので、こちらは適応されます。
    (偽 and TENPO = "店舗") )     偽かつ店舗条件なので、こちらは適応されません。

その為、店舗の条件を無視することができました。


・全店フラグに0を入れて実行した場合、実行される場合の条件式は以下のようになります。

  ( (0 = 1                               ) or
    (0 = 0 and TENPO = "店舗") )

つまり

  ( (偽                               ) or    偽の条件のみなので、こちらは適応されません。
    (真 and TENPO = "店舗") )     真かつ店舗条件なので、こちらは適応されます。

その為、店舗の条件を適応することができました。


上記の書き方をすれば、SASのマクロや、ストアドプロシージャを利用しなくても、
IF文のように利用することができます。
どうしても困ったときの対処方法としていかがでしょうか。

2015年12月16日水曜日

SAS Enterprise Guide(EG)でプロンプト(マクロ変数)を使う

ここ最近のお仕事で、SAS Enterprise Guide(EG)での開発が多いのですが、マクロ変数をGUIで設定できないものかと思う時があります。例えばお客様用にプロセスを開発する場合、期間抽出の条件を任意にしたいというご要望がある場合などです。プロンプトはそんな時に効果を発揮します。

結論から言うと、プログラム的にはマクロ変数と同じですが、プロセスフロー実行時に以下のようなウィンドウが出て、値を定義するように求められます。


これなら、値の設定を失念することもなくなりますし、お客様にEGPを提供する場合も負担が少なくてすみます。以下では期間抽出をプロンプトで行う方法を例に、プロンプトの定義方法をご紹介します。

以下のようなデータセットから、任意の年月の範囲をプロンプトで指定して、レコードを抽出してみましょう。


①クエリビルダからプロンプトマネージャを選択

 クエリビルダを開くと、プロンプトマネージャの項目があります。プロンプトマネージャを選択し、追加をクリックします。すると、プロンプト作成のウィンドウが出てきます。


プロンプトマネージャをクリック


追加を選択すると、プロンプトの作成画面が現れます。


②プロンプトの作成

 名前はわかりやすいものにしましょう。今回は年月を範囲指定して抽出するためのプロンプトを作成します。開始年月をSTART_YM、終了年月をEND_YMで作成します。

プロンプトにNULLを設定できないようにするには、「空白以外の値が必要」にチェックを入れます。


  「プロンプトの種類と値」のタブに移動すると、プロンプトの詳細定義が行えます。今回は数値変数に対する抽出を行う目的なので、「プロンプトの種類」は数値を選択します。また小数点以下は使用しないため、「整数値のみ許可する」にチェックを入れます。

最後に「最小値」、「最大値」を入力すれば、プロンプトの作成が完了します。


同様の手順でEND_YMも作成します。


③抽出条件にプロンプトを設定

 では、早速クエリビルダの抽出条件にプロンプトを使用してみましょう。変数「ym」に対して、演算子を「範囲内の値」します。
赤枠の部分をクリックすると、下記のようなウィンドウが表示されます。ウィンドウ内の「プロンプト」タブを選択すると、先ほど作成したプロンプトの一覧が表示されますので、「開始値」には「START_YM」、「終了値」には「END_YM」を選択します。

「開始値」、「終了値」の欄に直接「&START_YM」、「&END_YM」と直接入力しても構いません。


プログラムのプレビューを見ると、プロンプトが「&START_YM」、「&END_YM」になっており、内部的にはマクロ変数と同じ扱いになっていることがわかります。

では、クエリを実行しましょう。冒頭でご紹介した画面が出たので、値を入力します。2010年4月から2011年3月までのレコードを抽出してみましょう。

以下が実行結果です。

うまく抽出できています。
ちなみに、②でプロンプトにはNULL値を除外しているので、NULLを設定すると以下のようなエラーメッセージが表示されます。

後続の処理でプロンプトを使用する場合は以下の場所にチェックをいれましょう。


これによりプロセスフロー内で、プロンプトがマクロ変数として参照できるようになります。


2015年5月1日金曜日

説明力のある回帰分析モデルは使えない?

・株価の動きを説明する回帰モデルを作れば株で儲けられるのでは?

今回も回帰分析の話をします。例として、日経平均株価について回帰分析をして株価予測モデルを作ってみましょう。日経平均株価は「日経平均プロフィル」の以下のページから csv ファイルをダウンロードしました
http://indexes.nikkei.co.jp/nkave/index
この csv ファイルをSASに読み込みます。ただし、以下のプログラムでは、読み込んだデータセットを半分に分けています。これは、前半のデータでモデルを推定し、後半のデータで、推定したモデルを使って擬似的に株価予測をするためです。
/* パスは適宜変更してください */
%let csvpath=C:\Users\HOGEHOGE\Downloads\nikkei_stock_average_daily_jp.csv;
libname tmp "C:\Users\HOGEHOGE\Documents";
data work.stock;
    attrib  date  length=8 label='経過日数'          
    end   length=8 label='終値'
    start length=8 label='始値'
    high  length=8 label='高値'
    low   length=8 label='安値'
    _date_ length=8 label='日付' format=yymmdds10.        ;
    infile "&csvpath." dsd firstobs=2;
    input date: yymmdd10. end start high low;
    _date_=date;
    date = date- '03Jan2012'd;
run;
data work.stock_1 work.stock_2;
    set work.stock;
    /* 2013年8月14日で分割 */
    if _N_ <= 400 then output work.stock_1;
    else                output work.stock_2; run; 
日毎の株価終値の折れ線グラフが以下のようになります。
日々の上がり下がりはあるものの、全体として右上がりの傾向があります。そこで、経過日数を説明変数にして回帰してみましょう。このようなモデルです。
左辺の yt は株価終値を、右辺の t は経過日数を表し、 εt
は誤差を表します。先ほど分割したデータのうち、前半のデータを使い、reg プロシジャで計算します。
proc reg data=work.stock_1;
    NIKKEI:model end = date;
quit; 
結果が以下です。
係数が有意で、決定係数の値も 0.70 とかなり高めです。株価終値の実際の値と回帰直線をグラフにすると、こうなります (グラフはプロシジャ実行時に自動で作成されます)。
しかし、線形回帰モデルはつまり、データの特徴を直線で表現しようというものです。直線からはずれた大きな上下の波を説明することはできません。直線と実際の株価とで1000円単位の誤差があるのでは、実用に問題がありますね。

・多項式モデルなら株価の動きをかなり正確に説明できる

では、直線でなく曲線で回帰してみましょう。つまり、
というふうに経過日数の多項式にすれば上下に波のある株価の動きを表現できるはずです。 t2, t3, ... と続く t のべき乗を、t とは個別の説明変数と考えれば、これは実質的に重回帰と同じなので、最小二乗法で計算できます。まずは3次式
で回帰してみましょう。ここで、毎回コードを書くのは面倒なので、任意の次数の多項式で回帰するためのマクロを用意します。
%macro poly_reg(d=2);
    /* べき乗を計算*/
    data work.stock_1
         work.stock_2;
        set work.stock;
        %do i=1 %to &d.;
            date_&i. = date**&i.;
        %end;
        if _N_ <= 400 then output work.stock_1;
        else                output work.stock_2;
    run;
    /* 最小二乗法で推定*/
    proc reg data=work.stock_1
             outest=work.result_est;
        poly_&d.: model end = date_1-date_&d. ;
        output out=tmp.stock_1_est p=predict;
    quit;
    /* 外挿 */
    proc score data=work.stock_2
         score=work.result_est
         out  =work.temp(rename=(poly_&d.=predict))
         type=parms;
        var date_1-date_&d.;
    run;
    data tmp.stock_1_est_&d.;
        attrib  predict label='終値の予測値';
        set tmp.stock_1_est(keep=_date_ end predict);
    run;
    data tmp.stock_est_&d.;
        attrib  predict label='終値の予測値';
        set tmp.stock_1_est_&d.
            work.temp(keep=_date_ end predict);
    run;
%mend; 
このマクロではまず、次数に応じて経過日数の日付のべき乗の変数を作り、 reg プロシジャで回帰し、さらに score プロシジャを用いて、回帰に使わなかったほうのデータに対しても、推定結果から予測値を計算しています。大雑把ですが score プロシジャの構文の解説をすると,
proc score data=予測値を計算したいデータセット
           score=推定した結果(係数)の入っているデータセット
           out  =予測値の結果出力先データセット
           type =parms;
    var モデルの説明変数名の列挙;
run;
というふうになります。よって今回は data= に期間外のデータ work.stock_2 を、 score= には直前の reg プロシジャの推定結果を与えています。 type= は score= で指定した入力データセットが何なのかを指定しています. 今回は係数 (パラメータ) を格納したデータセットなので、type=parms と指定しています。このように、推定したモデルを期間外 ―つまりたいていは分析の後に得られた未来のデータ― に対して適用し、予測値を計算することを外挿または補外 (extrapolation) といいます。 予測値の計算だけをするので、外挿に必要なのは右辺の説明変数だけです。
ちなみに、今回は使いませんが、ロジスティック回帰をする場合なら、 logistic プロシジャ内で scoreステートメントを使うことで外挿ができるので、 score プロシジャは不要です。それ以外の回帰分析では、この score プロシジャを使います。
これで、 %poly_reg(d=); とするだけで、任意の次数の多項式で回帰分析してくれます。
重回帰分析になると、自動で当てはめプロットをしてくれないので自分でグラフを作る必要があります。
決定係数の値が大きくなっているため、「当てはまりの良さ」言い換えるなら説明力が向上しています。プロット図からも、
と、前よりも実際の株価の推移に近づいているように見えます。では、もっと多項式の次数を増やせばさらに近づくのでは無いでしょうか?
%poly_reg(d=5);
%poly_reg(d=8);
として、5次多項式と8次多項式についても回帰してみましょう。
5次多項式
8次多項式
5次、8次と次数を増やしていくほど、曲線が実際の株価の推移に近づいています。当てはまりの良さの指標である決定係数も増加しています。これは株で儲けるチャンスでは?

・過去の株価では取引できない

しかしこれで儲ける前に、予測結果についても見てみましょう。この回帰モデルは過去 (2012年1月4日から2013年8月14日) の株価データを使って作成しました。現在分かってる部分だけでなく将来の株価の動きも説明できなければ儲けることはできません。もちろん未来の株価が実際にどうなるかを知ることができません。そこで回帰分析の計算に使った期間より後のデータ (2013年8月15日から2015年4月)を使って、予測値と実績値の比較をすることで、擬似的に未来の株価を予測できているかを確認します。最初に株価のデータセットを2分割したのはこのためです。
まずは 3次式の予測結果...
当てはまっているようにも見えますが、やはり急激な動きには反応してませんし、後半の時期はだいぶ実績値から離れていますし、期間の端では曲線が逆方向へ伸びています。では、5次、8次多項式ではどうでしょうか。3次多項式より当てはまっていたので、もっとよく予測できるはず……
……ん? おかしいですね……、大きく下へ外れています。たまたま調子が悪かったのかもしれません。8次多項式のほうはどうでしょうか?
予測値が上へ大きく伸びているので、本来の株価の推移が平たく潰れてしまっています。予測としてまったく用をなしません。

・木を見て森を見ず

種明かしをすると、これは過剰適合 (overfitting) という現象です。機械学習の分野では過学習 (overlearning) とも呼ばれます。推定に用いるのは限られた期間のデータなので、このデータだけにモデルをぴったり合わせようとすると、この期間にたまたま起こったノイズ的な事象にまで合わせようとしてしまい、結果としてそれ以外の期間の予測精度が悪くなります。長期間ある株価の動きのうちの一部の限られた部分だけを見て、都合のよい解釈をしてしまっている、まさに「木を見て森を見ず」という状態です。
もうひとつ、過剰適合が問題だと直感的にわかる例を挙げます。さいころを6回振って、2の目がたまたま3回出たとします。では、この事実からさいころの2の目が出る確率が1/2だと言えるでしょうか?
ましてや株価の動きは、さいころを振ってどの面が上を向くか、という現象よりはるかに複雑な現象です。このさいころの例のような明らかな誤解も、複雑すぎる問題のなかでは誤解であると気づけないことが多々あります。
今回これらのモデルは、モデルの当てはまりの良さの指標である決定係数がかなり高かったのですが、このように、決定係数が高い=予測性能が高い、ではないことが分かります。一般に、説明変数が増えるほど過剰適合が起こりやすくなります。今回の場合、むやみに次数を増やすことで説明変数が増えていました。当てはまりの良さだけを考えて回帰分析するのは非常に危険です。
では、どうすれば過剰適合を回避できるのでしょうか。いくつか方法があります。
  1. 今回のように、データを係数の推定用と外挿用に分割する。外挿結果があまりに実績値と外れていれば、そのモデルは過剰適合である、ということが分かります。この方法は実際には今回のようにグラフを確認するだけでなく、より厳密で複雑な手続きがあり、「交叉検証法(クロス・バリデーション)」と呼ばれます。
  2. 「情報量規準 (information criterion)」を用いる。これは複数のモデルの候補があって、最終的にどれが一番予測性能があるか (=過剰適合が少ないか) を選ぶときに使用できます。モデルの当てはまりの良さを表す指標に対して、説明変数の数に応じて減点して求めた指標「情報量規準 」を用います。
  3. 「調整済み R2 乗」を使う。 reg プロシジャの結果にある「調整済み R2 乗」というのは、この過剰適合に対応した決定係数で、過剰適合があってもあまり値が大きくならないよう、通常の決定係数とは計算方法を変えています。しかし今回のように、過剰適合があっても値が大きくなることもよくあるので、絶対ではありません。そのため、上記2つに比べると、これはあくまで目安です。
最後に重要なのですが、過剰適合というのは、「モデルを説明しない」変数をむやみに追加することで発生します。つまり、過剰適合のあるモデルとは、適当な数字を説明変数として詰め込んで作られたハリボテのようなものです。というわけで、今回の株価予測モデルは、実際には意味のない説明変数を使って説明したように見せかけただけですので、これで儲けることはできません (身も蓋もないですが、そもそもそんなモデルを発見しても誰にも言いません)。過剰適合を回避するとは、無意味な説明変数を切り捨て、本質的な法則性を表す説明変数だけを残すようにモデルを洗練するということです。

・まとめ

  • 分析に使えるデータは常に、全体の限られたごく一部。
  • 限られたデータだけを説明しようとすると「木を見て森を見ず」状態になる (過剰適合)。
  • 過剰適合を回避する方法がある。
  • 重要なのは、背後に隠されたメカニズムを意識してモデルを作ること

・おまけ

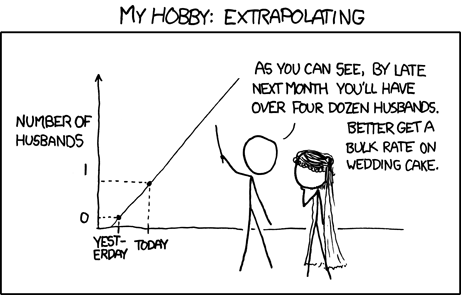
xkcd というサイトに掲載されている、無茶な設定の予測モデルに関する漫画です。今回の話のように、限られたデータだけしか見ないで、背後の因果関係を無視していることを笑いの種にしています。
「グラフを見てわかるように、翌月には夫が40人を超えます。ウェディングケーキをまとめ買いするといいでしょう」
「グラフを見てわかるように、翌月には夫の数が大きなマイナスになります。全員分 (マイナス個) のウェディングケーキを買えば儲かるでしょう」
上記画像は xkcd により、 クリエイティブ・コモンズ 表示 - 非営利 2.5 一般 ライセンスの下に提供されています

2014年8月22日金曜日

Call Symputルーチンによるマクロ変数作成の豆知識

マクロ変数は、プログラム内で場所を選ばず展開できる「グローバルマクロ変数」と
%MACRO ~ %MEND;内でのみ展開できる「ローカルマクロ変数」があります。


また、マクロ変数は下記の方法で定義することができます。
 1.%LETステートメント
   ・%MACRO ~ %MEND;内で宣言 ・・・ 「ローカルマクロ変数」として定義
   ・%MACRO ~ %MEND;外で宣言 ・・・ 「グローバルマクロ変数」として定義

 2.%MACROステートメント内のパラメータ
   ・「ローカルマクロ変数」として定義

 3.%DOループのインデックスマクロ変数
   ・「ローカルマクロ変数」として定義
    
 4.Call Symputルーチン
   ・通常は%MACRO ~ %MEND;の内外問わず「グローバルマクロ変数」として定義


 ただし、4.Call Symputルーチンは下記の様な場合、「ローカルマクロ変数」として定義されます。
     A.%MACRO ~ %MEND;内でCall Symput以前にローカルマクロ変数が定義されている場合
     B.PROC SQLの後で、Call Symputを使用した場合
     C.マクロ呼び出しの際にマクロ変数SYSPBUFFを作成した場合
     D.同じ%MACRO ~ %MEND;内に、「&~」や「%~」を含む%GOTOステートメントがある場合


さて、今回はA.のパターンについて紹介したいと思います。


以前、現場で「基準年月」から「6ヶ月間」分のデータを取得し集計するご依頼をいただき

私は、6ヶ月分のデータを取得する下記の様なマクロを作成しました。

※実際に作成したプログラムとは、多少変えてあります。


  %let yymm = 1403;  /* 基準年月 */

  %macro aaa;           /* 基準年月から6ヶ月分の年月を取得するマクロ */

    %do i = 1 %to 6;

         data _null_;
            ym = put(intnx('mon',input("&yymm",yymmn4.),&i-1),yymmn4.);
            call symput("yymm&i",compress(ym));
         run;

    %end;

  %mend;
  %aaa;
  
  %put 1ヶ月目 = &yymm1;  /* チェック用 */


ところが、プログラムを作成し実際に実行してみると%putステートメントの処理の際に、

次の様なメッセージがログに出ました。

 Warning : 記号参照 YYMM1 を展開していません。


思わぬWarningの出現に首をかしげてしまいました。


Warningの原因は、%doステートメント内のマクロインデックス変数 &i でした。

&i がCall Symput以前に定義されていたため、マクロ変数 &yymm1 は「ローカルマクロ変数」として

定義されてしまったのです。


色々、検証してみた末、原因が判明したので、私は下記の様な対処方法を考えました。

 A.) Call Symputで定義したマクロ変数を%GLOBALステートメントを使用してグローバル化する


         %let yymm = 1403;  /* 基準年月 */

         %macro aaa;           /* 基準年月から6ヶ月分の年月を取得するマクロ */

           %do i = 1 %to 6;

                 %global yymm&i;  

                 data _null_;
                    ym = put(intnx('mon',input("&yymm",yymmn4.),&i-1),yymmn4.);
                    call symput("yymm&i",compress(ym));
                 run;

           %end;

        %mend;
        %aaa;
  
        %put 1ヶ月目 = &yymm1;  /* チェック用 */


  B.) マクロを使用しない


          %let yymm = 1403;  /* 基準年月 */
    
          data _null_;
             do i = 1 to 6;
                 ym = put(intnx('mon',input("&yymm",yymmn4.),i-1),yymmn4.);
                 call symput(compress('yymm' || put(i,best.)),compress(ym));
             end;
          run;

          %put 1ヶ月目 = &yymm1;  /* チェック用 */


A・Bどちらのパターンでも「グローバルマクロ変数」として定義され

私の望んだ結果を得ることができました。


皆さんも頭の片隅にでも留めておいて頂けたら意外と役に立つかもしれません。


以上、文章での説明が苦手なので読みにくい点が多々あると思いますが、
最後まで読んで下さった方はありがとうございました。

2007年9月20日木曜日

%EVALでの計算における注意点


V8で%EVALでの計算結果の有効範囲は-2147483647~2147483647で


4バイト(符号の1ビット+31ビット)になります。


計算結果がこれを超えるとオーバーフローを起こします。


下記のようになります。


_/_/_/_/_/_/_/_/_/_/ program _/_/_/_/_/_/_/_/_/_/


%LET num1 = %EVAL(2147483646 + 1) ;


%PUT num1 : &num1 ;


%LET num2 = %EVAL(2147483646 + 2) ;


%PUT num2 : &num2 ;


%LET num3 = %EVAL(-2147483646 - 1) ;


%PUT num3 : &num3 ;


%LET num4 = %EVAL(-2147483646 - 2) ;


%PUT num4 : &num4 ;


_/_/_/_/_/_/_/_/_/_/_/ log _/_/_/_/_/_/_/_/_/_/


3274 %LET num1 = %EVAL(2147483646 + 1) ;


3275 %PUT num1 : &num1 ;


num1 : 2147483647


3276 %LET num2 = %EVAL(2147483646 + 2) ;


ERROR: オーバーフローが発生しました。計算を中止します。


3277 %PUT num2 : &num2 ;


num2 :


3278 %LET num3 = %EVAL(-2147483646 - 1) ;


3279 %PUT num3 : &num3 ;


num3 : -2147483647


3280 %LET num4 = %EVAL(-2147483646 - 2) ;


ERROR: オーバーフローが発生しました。計算を中止します。


3281 %PUT num4 : &num4 ;


num4 :


また、%IF~%THENでの値の比較に関しても、


片方の値が-2147483647~2147483647を超えるとオーバーフローします。


下記のようになります。


_/_/_/_/_/_/_/_/_/_/ program _/_/_/_/_/_/_/_/_/_/


%macro test1 ;


 %let test1 = 2147483647 ;


 %if &test1 = 100000 %then %do ;


  %put 条件一致 ;


 %end ;


 %else %do ;


  %put 条件不一致 ;


 %end ;


%mend ;


%test1;


%macro test2 ;


 %let test2 = 2147483648 ;


 %if &test2 = 100000 %then %do ;


  %put 条件一致 ;


 %end ;


 %else %do ;


  %put 条件不一致 ;


 %end ;


%mend ;


%test2;


_/_/_/_/_/_/_/_/_/_/_/ log _/_/_/_/_/_/_/_/_/_/


3282 %macro test1 ;


3283  %let test1 = 2147483647 ;


3284  %if &test1 = 100000 %then %do ;


3285   %put 条件一致 ;


3286  %end ;


3287  %else %do ;


3288   %put 条件不一致 ;


3289  %end ;


3290 %mend ;


3291 %test1;


条件不一致


3292 %macro test2 ;


3293  %let test2 = 2147483648 ;


3294  %if &test2 = 100000 %then %do ;


3295   %put 条件一致 ;


3296  %end ;


3297  %else %do ;


3298   %put 条件不一致 ;


3299  %end ;


3300 %mend ;


3301 %test2;


ERROR: オーバーフローが発生しました。計算を中止します。


ERROR: マクロ TEST2 の実行を中止します。


※ "="の部分は"^="、">"、">="、"<"、"<="でも同様です。


つまり、マクロプロセッサに計算させる場合、


有効な値は-2147483647~2147483647の4バイトになります。


ちなみに、%EVALでオーバーフローする場合は、%SYSFUNC(SUM())で対処できます。


また、%IF~%THENでオーバーフローする場合は、マクロ変数をダブルクォーテーションで括ることで、対処できます。


[google]

ネイチャーインサイト サイトリニューアル&NIBLOGの引っ越し

ご連絡が遅くなりましたが、 ネイチャーインサイトの際とがリニューアルしました。 https://www.n-insight.co.jp/ それに伴い、NIBLOGも引っ越しすることになりました。 https://www.n-insight.co.jp/niblog/ ...