ラベル ■SAS Tips集 の投稿を表示しています。 すべての投稿を表示

2017年5月22日月曜日

優れた予測モデルとは: SAS GLMSELECT プロシジャの紹介


関係のない説明変数をむやみに追加して決定係数 (= 説明力 ) を闇雲に増やしても、予測モデルとしてはつかえません。そのようなモデルはデータで見える範囲のものだけを都合よく解釈したものにすぎません。決定係数ではなく、情報量基準を用いる、交差検証 (クロスバリデーション) を行う、罰則付き回帰を用いる、といった方法で本当に意味のある変数だけを選ばなければ「良いモデル」にはなりえません。ここでいう「良いモデル」とは説明力ではなく「予測性能のよいモデル」のことです。闇雲に説明変数を追加したモデルがどうして良くないかは、以前書いた「 説明力のある回帰分析モデルは使えない?」をご覧ください。

KDNuggets より, Ted Goff の漫画
そこで、今回はこの問題を具体的に解決する方法の1つとして、GLMSELECT プロシジャの扱い方を説明したいと思います。まず、情報量基準と交差検証法、そして変数選択法を簡単に説明します。そのうえで、メジャーリーグ選手の成績データと年俸のデータを例にして、GLMSELECT プロシジャの使い方を解説します。単に GLMSELECT の使い方だけを知りたい方は、これらを飛ばして後半のGLMSELECTプロシジャの使い方から読み始めてください。

情報量規準とは

情報量規準とは、いくつかのモデルの候補があるとき、それらのうちどれがより良いモデルかを判断するための指標です。変数を入れ替えて何度も回帰モデルを計算し、情報量基準が小さいモデルを採用します。情報量基準にはいくつかバリエーションがあり、その中でも赤池の考案した赤池の情報量基準 (AIC) と Schwarz の考案したベイジアン情報量基準 (BIC, SIC) がよく利用されます。両者は用途と計算方法が違うので、必ずしも同じ結果になりません。BIC は AIC よりも少ない変数が選ばれる傾向があります。しかし、どちらがより優れた情報量基準か、ということは断言できないので、目的に応じて使い分けられます。AIC は「より予測性能がよいモデルを選ぶ」ことができ、BIC は「より正しいモデルが選ばれる確率を最大化する」指標です。「ベイジアン」という名前ですが、これはベイズの定理を利用して計算している、という程度の意味であり、いわゆるベイズ統計モデルだから BIC を使わなければならないとか、ベイズモデルじゃないから BIC を使ってはならない、ということではありません。他にも DIC, WAIC と呼ばれる情報量規準が有名ですが、前者はベイズ統計で、後者は一部の特殊なモデルで使用することを前提に作られたものなので今回は使用しません。

交差検証法とは

情報量規準のほかに、データセット全体を計算用と予測用に分けて予測性能を確認するという方法があります。これは「ホールドアウト検証」と呼ばれます。計算用の部分は「訓練データ」、予測性能の確認の部分は「テストデータ」とか「評価データ」とか呼ばれます。データセットのレコード数が十分にあるならばこれで良いのですが、少ない場合はこの分割によってさらに計算に使えるデータセットが減ってしまうので、交差検証法を使います。例えば 1 抜き交差検証(leave-one-out CV, LOOCV) と呼ばれる方法ならば、データセットから 1レコードだけ除いて計算し、その予測値と残り 1 レコードの値を誤差とします。つまりホールドアウト検証を繰り返しているようなものです。これをすべてのレコードについて繰り返します[1]。つまり、データセットが100レコードならば、99個のレコードで回帰モデルを計算するのを100回ぶん行うわけです。この100個すべての誤差の平均が、そのモデルで予測するときの誤差の大きさになります。この指標は「汎化誤差」と呼ばれたりします。よって、2つのモデル候補があったとして、この誤差の小さいほうが、より良いモデルになるということです。しかし、たとえばデータが数十万レコードもあるときは、計算量が膨大になってしまいます[2]。そこで、サンプルを幾つかのグループに分割し、グループ単位で計算と誤差の評価を繰り返す方法がよく取られます。この方法はk-分割交差検証といいます。たとえばレコードを10 個のグループに分けた場合、10回繰り返せば計算が終わります。

では、情報量規準と交差検証とどちらがよいのか、という点に疑問を持つ方が出てくると思います。交差検証法のうち LOOCV と情報量規準は、レコード数が十分に多ければ結果が一致します。しかし、情報量規準の多くは、使用するには条件があり、この条件を満たさない複雑なモデルには適用できません。逆に交差検証は原理が単純なので、どのような複雑なモデルに対しても原則として使用可能です。一方で、すでに述べたように交差検証法は計算量が多いです。GLMSELECT プロシジャがあつかう線形回帰モデルでは、情報量規準が使用可能なので、計算の簡単さの点で情報量規準が優位ですが、情報量規準も推定量の一種なので、結果には誤差があります。なので「どちらを使えばいいか」ではなく「どういうときに使ってはいけないか」だけを覚えておけばいいと思います。

変数選択法

交差検証法も情報量基準も与えられたモデルを評価する方法なので、そもそも、どうやって変数を取捨選択するか、ということを考える必要があります。変数の組み合わせを総当りでやっていたのでは大変です。例えば 10 個の変数があったとしたら、 \(2^{10}-1=1023\) 通りも計算しなければなりません。そこで、「増加法」「減少法」「ステップワイズ法」と呼ばれる変数選択法のルールに基づいて変数を選ぶのが一般的です。「増加法」の場合、\(K\) 種類の変数候補のうち 1 つだけを含んだモデルを計算し ( つまり \(K\) 個のモデルを計算します ) 、その中で一番情報量基準が小さいモデルを選びます。どの変数を追加しても情報量基準が増えてしまうなら、そこで終了です。こうして変数を 1 つ含んだモデルに対し、同様の手順で残った \(K-1\) 個の変数から 1 つ変数を選びます。このため、総当りで \(2^K-1\) 回計算するよりはだいぶ計算回数が減ります。「減少法」は逆に、変数候補をすべて含んだモデルを最初に計算し、そのなかから、除外することでモデルの情報量基準を一番小さくできる変数を順に除外していきます。「ステップワイズ法」は増加法と減少法の折衷のような方法で、「増減法」とも呼ばれます。ステップワイズ法では、増加法のように情報量基準で1つ変数を追加したら、今度はすでに含まれている変数から最も情報量基準を大きくしている変数を除外します。情報量規準ではなく、交差検証で求めた汎化誤差の一番小さい変数を選ぶ、という方法でもいいです[3]。

野球選手の年俸はどうやって予測できるか ?

SAS の SASHELP ライブラリに、動作確認のための様々なデータセットがあるのはご存知でしょうか ? その中にある baseball データセット[4]には、 1986 年の MLB で活躍した約 400 名の野手の成績と通算成績、そして翌年の年俸が記録されています。選手の年俸がどのようにして決まるかは人気などもあるかもしませんが、成績の優秀な選手ほど高額な年俸を得られそうだと考えるのが自然です。よって、盗塁数、打点、本塁打数などの数字を説明変数として、それぞれの要素がどう年俸に影響しているか分析してみましょう[5]。野球は 1986 年以外の年にも行われていますし、収録されていない野手も存在するので、より広範囲で当てはまるモデルを作るにはデータに対するモデルの当てはまりの良さだけでなく、予測性能も考慮して説明変数を決めなければなりらないのは明らかです。まず、sashelp.baseballの変数名が分かりづらいので、名前を日本語にしておきます。


options validvarname=any;
data work.baseball(rename=(
            Name      =   '氏名'n
            Team      =   'チーム'n
            nAtBat    =   '打席数'n
            nHits     =   '安打'n
            nHome     =   '本塁打'n
            nRuns     =   '得点'n
            nRBI      =   '打点'n
            nBB       =   '四球'n
            YrMajor   =   'MLB年数'n
            CrAtBat   =   '通算打席数'n
            CrHits    =   '通算安打'n
            CrHome    =   '通算本塁打'n
            CrRuns    =   '通算得点'n
            CrRbi     =   '通算打点'n
            CrBB      =   '通算四球'n
            League    =   'リーグ'n
            Division  =   '地区'n
            Position  =   'ポジション'n
            nOuts     =   '刺殺'n
            nAssts    =   '補殺'n
            nError    =   'エラー'n
            Salary    =   '年俸(千ドル)'n
            Div       =   'リーグと地区'n
            logSalary =   '対数年俸'n
        ));
    set sashelp.baseball ;
run;
proc contents data=work.baseball varnum ;
run;

GLMSELECT プロシジャの使い方

GLMSELECT プロシジャは、 SAS/STAT 13 で追加されたプロシジャです。基本的な構文は REG や GLM プロシジャと同じですが、 MODEL ステートメントのオプションで変数選択の方法をいろいろと細かく指定できます。REG や GLM プロシジャにも変数選択の機能がありますが、 GLMSELECT はこれらの拡張版といえます。この GLMSELECT プロシジャを使って、メジャーリーガーの年俸予測式を作ってみましょう。

まず、ステップワイズ法+AICで回帰モデルに使用する変数を決めてみます。model 文の後に / selection=stepwise(select=AIC) というオプションを入れることで実行できます。これは、変数選択はステップワイズ法を用いて、選択の基準は AIC で判断する、ということです。増加法ならば forward, 減少法なら backward になります。


proc glmselect data=work.baseball plots=all ;
    class リーグ 地区 チーム ポジション ;
    model 対数年俸 = 打席数 安打 本塁打 得点 打点 四球 MLB年数 通算打席数 通算安打 通算本塁打 通算得点 通算打点 通算四球 刺殺 補殺 エラー リーグ ポジション 地区 チーム
            / selection=stepwise(select=AIC) details=all stats=(adjRsq AIC AICC SBC) ;
run ;

plots=all と details=all は最小限の結果だけを見たい場合は不要です。さらに、stats= オプションで他の指標もグラフに表示させ、比較しています。 namelen=200 は、変数名を日本語にすることで表示がおかしくなるのを防ぐために追加しました。stats= オプションで表示しているのは、adjRsq は調整済みR2乗、AICC は有限修正AICといい、レコード数が少ない場合にAICより精度が高くなるといわれています。SBC は BICのことです。紛らわしいのですが、 GLMSELECT では BIC と指定すると、シュワルツの BIC ではなく、佐和のベイジアン情報量規準が指定されてしまいます。佐和のBICは名前に反してむしろAICに近い指標ですが、ほとんど使われているのを見たことがないので、以降も文中でBICと言ったらシュワルツのことだと考えてください。修正済み R2 乗は通常の R2 乗よりも過剰適合に強い指標ですが、理論上、予測性能を保証するものではないので、理論的に裏付けのある情報量規準を使うべきです。

先のプログラムを実行すると、以下のようなグラフが表示されます。


ステップワイズ+AICの結果
変数の増加にともない、各指標がどう推移していったかがわかります。AICとAICCは増加に伴い小さくなっていくのに対し、BICは4つ目の変数追加のときに最小となっています。

次に、LOOCV で変数選択を行った場合は以下のようになります。

proc glmselect data=work.baseball plots=all namelen=200 ;
    class リーグ 地区 チーム ポジション ;
    model 対数年俸 = 打席数 安打 本塁打 得点 打点 四球 MLB年数 通算打席数 通算安打 通算本塁打 通算得点 通算打点 通算四球 刺殺 補殺 エラー リーグ ポジション 地区 チーム
            / selection=stepwise(select=press) stats=(adjRsq AIC AICC SBC) ;
run ;

ステップワイズ+LOOCVの結果
今度は 11個の変数が選ばれています。AICやBICを見ると違いがよくわかります。ホールドアウトの場合はオプションに selection=stepwise(select=validate) と指定します。また、データセットを訓練データと学習データに分ける必要があります。ここでは、無作為に3割のレコードをテストデータに割り当てる方法を紹介します。オプションではなく partition ステートメントを使うことで設定できます。

proc glmselect data=work.baseball plots=all namelen=200 ;
    class リーグ 地区 チーム ポジション ;
    model 対数年俸 = 打席数 安打 本塁打 得点 打点 四球 MLB年数 通算打席数 通算安打 通算本塁打 通算得点 通算打点 通算四球 刺殺 補殺 エラー リーグ ポジション 地区 チーム
            / selection=stepwise(select=validate) details=all ;
            partition fraction(validate=.3) ;
run ;

さらに10分割CVの場合は、

proc glmselect data=work.baseball plots=all namelen=200 ;
    class リーグ 地区 チーム ポジション ;
    model 対数年俸 = 打席数 安打 本塁打 得点 打点 四球 MLB年数 通算打席数 通算安打 通算本塁打 通算得点 通算打点 通算四球 刺殺 補殺 エラー リーグ ポジション 地区 チーム
            / selection=stepwise(select=cv) cvmethod=random(10) details=all ;
run ;

となります。cvmethod= はデータセットの分割方法の指定で、randam(10) は無作為に10グループに分けるという意味です。

なお、R2乗で変数選択した場合はこのようになります。
全変数
R2乗はどのような変数を追加しても値が改善されるため、すべての変数を含む結果になりました。明らかにLOOCVや情報量規準の結果とは異なります。

GLMSELECTでは他にもいろいろな方法を使えますが、今回は情報量規準と交差検証法を利用する方法だけを紹介しました。

2016/7/29 片桐

参考文献

  1. 赤池弘次 他 (2007)「赤池情報量規準 AIC―モデリング・予測・知識発見― 」共立出版
  2. 小西貞則・北川源四郎 (2004) 「情報量規準」朝倉書店
  3. Gelman, Andrew et al. (2009) Bayesian Data Analysis, 3rd Ed., CRC Press
  4. SAS Institute Inc. (2015) SAS/STAT(R) 14.1 User's Guide

  1. 少し詳しい方なら、ジャックナイフ法やブートストラップ法と同じ発想だとわかるでしょう。
  2. ただし、実はこの計算を簡単にする方法があります。
  3. 変数選択にはF統計量に対応するp値を使用するという伝統的なやり方がありましたが、現在ではこれは問題があることが分かっているので、使用しないほうがよいです。
  4. 最新のバージョンでないと入っていない可能性がありますが、SAS University Edition なら入っているはずです。
  5. 期待していたら申し訳ないのですが、株で儲ける方法をテーマにする予定はありません。

2016年4月19日火曜日

SAS でアニメーション作成 ~中心極限定理のデモ~

なぜ中心極限定理か

SAS は 9.4 以降から使用可能になった ods animation オプションでアニメーション作成もできます (といっても静止画をコマ送りにするだけですが)。最近、 『可視化で理解する中心極限定理 #rstatsj - qiita』という記事で R 言語で中心極限定理のアニメーションが作成されてるのを見かけたので、ods animation を利用して SAS でも似たようなことをしてみました。
まず、中心極限定理の簡単な説明をします。中心極限定理を知っているという方は次のセクションまで読み飛ばしてかまいません。
中心極限定理というのは、「一定の条件をみたすならどんな確率分布のデータでも、その平均値を以下のような形で変換すれば、観測数 (レコード件数) が多いほど標準正規分布に近づくようになる」
というものです。X̄N というのが実際のデータの算術平均 (このデータには N 件のレコードがあるとします。N 個の値の平均です) で、μ は理論上の平均、 σ は標準偏差です。
とか
のような書き方をしている教科書もありますが、どれも同じ意味です。中心極限定理というものが存在するので、元の分布が分からなくても、(レコード数が多ければ) 正規分布に近づくので、有意検定とか、カイ二乗検定などいろいろな仮説検定が可能になるので、推理統計学 (数理統計学) では非常に重要な理論です。
しかし、分布が近づく、というのは非常にイメージしにくいでしょう。「大数の法則」ならば、レコード数が増えれば算術平均が真の値に収束する、ということでイメージしやすいのですが、中心極限定理は点ではなく分布、つまり「バラつき」がある形に収束する、ということで、いくらか抽象的です。そこで、アニメーションを用いて中心極限定理の視覚的なイメージを与えてみましょう。

SAS コード

まず、SAS でアニメーションを作成する方法は、SAS公式のリファレンスで確認できます (2015年5月12日現在英語のみ)。 日本語で解説したものとしては SAS忘備録さんの 『SASでアニメーションを作る方法(SAS9.4以降)』 などが参考になります。これを元に、少しづつレコードを増やした場合のヒストグラムを次々表示することで、ヒストグラムが標準正規分布の形に近づいていく様子を見せたいと思います。
しかし、あるデータから計算できる平均値は1つの数字だけです。つまり、1つの点でしかないのでヒストグラムで分布を表現できません。そこで、SF ちっくな表現ですが、あたかも平行世界があるように、「あるデータ」を何度も複製して、それぞれの平均をとることで平均値の分布を取ります。つまり、N 件レコードのあるデータを M 回複製する、ということです。もちろん、それぞれのデータの中身が全く同じであっては意味がありませんので、以下のようなイメージで乱数で作成します。
データ1 データ2 ...
1.0 1.1 1.2 1.5
2.0 2.1 1.9 2.5
3.0 3.1 3.5 3.0
1 0 1 1
平均値をいくつも計算する必要があるだけなので、実際には N×M 件のレコードがあれば別々のデータセットにする必要はありません。そのため、この後に掲載するコードでは1つのデータセットだけを作成しています。
さて、今回は、どんな分布でも標準正規分布になることを確認したいので、正規分布、カイ二乗分布、ベルヌーイ分布の3種類で試してみます。これら3種類の分布はどれも、理論上の平均値と分散がわかっています (標準偏差の2乗が分散なので、逆に分散の平方根をとれば標準偏差がわかります)。

正規分布は、パラメータとして平均と分散の値を自由に指定することができます。ただし、SAS の関数では、分散の代わりに標準偏差を指定する必要があります。正規分布は左右対称な山なりの分布で、山の頂点がちょうど平均値になります。つまり、平均値で指定した値が発生しやすく、平均値から離れた値ほど発生しにくくなります。平均がゼロ、分散が1の正規分布を特に標準正規分布といいます。中心極限定理は標準正規分布に収束するという話なので、今回は平均が10、分散が25の正規分布にします。

カイ二乗分布は、正の値しかないような分布です。そのため、分布は山なりですが、正規分布のように対称ではありません。k というパラメータで形が決まります。今回は 2 にしました。カイ二乗分布の平均は k、分散は 2k であることがわかっています。
ベルヌーイ分布というのは、 0 か 1 の2通りしか発生しない分布です。たとえば、コイン投げの結果も表か裏の2通りしかないので、ベルヌーイ分布と考えられます。ベルヌーイ分布は、1 になる確率、コイン投げでいうなら表が出る確率 p の値で分布の形が決まります。0.5 にしてもいいのですが、面白くないので 0.01 というとても不公平な値に設定しましょう。これで裏 (ゼロ) が出る確率が 99.9 パーセントになるので、非常にゼロに偏った分布になります。ベルヌーイ分布の平均は p、分散は p(1-p) になることがわかっています。
今回の場合、3つの分布はだいたいこんな感じになります。
(正規分布)

(カイ二乗分布)

(ベルヌーイ分布)

以上を踏まえて、以下のコードでデータを複製します。とりあえず、500件のレコードのデータを500個複製してみました。それぞれ最初のマクロ変数 size と rep で数を調整できますが、大きくし過ぎると計算に時間がかかります。
/* 保存先フォルダ。末尾に\ や / の区切り記号をつけてください*/
%let path =hogehoge;

%let m    = 10;    /* 正規分布の平均 */
%let s    = 5;    /* 正規分布の標準偏差 */
%let k    = 2;    /* カイ2乗分布の自由度 */
%let p    = .01;   /* ベルヌーイ試行の成功確率 */
%let size = 500; /* 最大サンプルサイズ*/
%let rep  = 500; /* 試行回数*/
%let f    = 20;   /* アニメーションのコマ数*/

%let d=%eval(&size./&f.) /* 1コマごとに増やすサンプルサイズ*/;

/* サイズ size のサンプルを rep 回作成 */
data work.random(keep= j normal chisq bernoulli);
    do i=1 to &rep.;
        do j=1 to &size.;
            /* 3種類の乱数を生成 */
            r_normal    = rand('Normal', &m., &s.);
            r_chisq     = rand('ChiSqaure', &k.);
            r_bernoulli = rand('bernoulli', &p.);

            /* 平均を求めるために累積和を計算 */
            c_normal    + r_normal;
            c_chisq     + r_chisq;
            c_bernoulli + r_bernoulli; 
            /* 算術平均 */
            m_normal     = c_normal    / j;
            m_chisq      = c_chisq     / j;
            m_bernoulli  = c_bernoulli / j;
            /* 標準化 */
            normal    = sqrt(j) * (m_normal - &m.) / &s.;
            chisq     = sqrt(j) * (m_chisq - &k.) / sqrt(2*&k.);
            bernoulli = sqrt(j) * (m_bernoulli - &p.) / sqrt(&p.*(1-&p.));
            output;
        end;
        c_normal    = 0;
        c_chisq     = 0;
        c_bernoulli = 0; 
    end;
run;
ループ処理で作成しているので、 j がレコード件数に対応しています。500回複製しているので、レコード j 件のデータの平均値は 500通り存在することになりますので、平均値のヒストグラムが作成できます。
これで必要なデータが出来ましたので、次に以下のようなマクロでヒストグラムのアニメーションを作成します。
%macro clt(var);
    options  animation=start animduration=0.2   printerpath=GIF;
    ods printer file="&path.clt_demo_&var..gif"  ;
    /* 表示範囲をそろえるために最大絶対値を取得*/
    proc summary data=work.random;
        var &var.;
        output out=work.maxinterval min=min max=max;
    run;
    data _null_;
        set work.maxinterval;
        interval = ceil(max(abs(min), max));
        call symput('interval', interval);
        stop;
    run;    
    /* 最初のコマを長く表示*/
    %do k=1 %to 5;
        %hist(1);
    %end;
    /* 各コマのヒストグラムを順に表示*/
    %do i =1 %to &f.;
        %let l = %eval(&i.*&d.);
        %hist(&l.);
    %end;
    /* 最後のコマを長く表示*/
    %do k=1 %to 5;
        %hist(&size.);
    %end;

    ods printer close ;
    options  animation=stop ;
%mend;

/* 各コマのヒストグラムと分布曲線を描くマクロ*/
%macro hist(x);
    title "N=&x.";
    proc univariate data=work.random(where=(j=&x.)) noprint;
        var &var.;
        histogram / midpoints = -&interval. to &interval. by .5
                    vaxis     = 0 to 50 by 10
                    kernel
                    normal (noprint w=1 l=1 mu=0 sigma=1);
        inset mean std;
    run;
%mend;
univariate プロシジャで、さきほど作成したデータセットから、j=x に対応するレコードを抜き出して、 x 件のレコードを持つデータの平均値のヒストグラムを作成しています。また、ヒストグラムに重ねて理論上の分布曲線を描きます。1つは normal というオプションで描かれる標準正規分布、もう1つは kernel オプションで描かれる、ヒストグラムを滑らかにした曲線です。これはカーネル法と呼ばれる方法で作成できる曲線で、そのデータの擬似的な確率分布とみなせます。よって、中心極限定理がうまくはたらいているなら、このカーネル法による曲線が標準正規分布の曲線に重なっていくはずです。また、左上に平均と標準偏差を表示しました。中心極限定理がはたらいているなら、標準正規分布の平均と標準偏差であるゼロと 1 にそれぞれ近づくはずです。
アニメーションの1コマの表示時間は animduration= で指定できます (単位は秒です) が、一律同じなので、特定のコマだけ長く表示、ということは出来ません。そこで、最初と最後のコマは同じヒストグラムを何度も表示することで、長めに表示しているように見せています。
このマクロは、3つの分布でのアニメーションを別々に作成しますので、以下のように3回呼び出して使います。
%clt(normal); /* 正規分布の場合*/
%clt(chisq); /* カイ二乗分布の場合*/
%clt(bernoulli); /* ベルヌーイ分布の場合*/
すべて完了するまで数分かかるかもしれませんが、これで3種類のアニメーションが完成します。まずは正規分布の場合です。青い曲線が標準正規分布で、赤い曲線がカーネル法による曲線です。
元の分布が正規分布なので、最初からあまり代わりません。最後が少し歪んでいますが、まあ乱数なのでそういうこともあります...。次にカイ二乗分布の場合。
こちらは、最初は元のカイ二乗分布のように左に歪んでいますが、すぐに対称な正規分布の形に近づいていきます。
そして、一番おもしろい動きをするのがベルヌーイ分布です。
ということで ベルヌーイ分布であっても中心極限定理が成立することが視覚的にわかりました。
2015/5/15 片桐

2015年12月16日水曜日

SAS Enterprise Guide(EG)でプロンプト(マクロ変数)を使う

ここ最近のお仕事で、SAS Enterprise Guide(EG)での開発が多いのですが、マクロ変数をGUIで設定できないものかと思う時があります。例えばお客様用にプロセスを開発する場合、期間抽出の条件を任意にしたいというご要望がある場合などです。プロンプトはそんな時に効果を発揮します。

結論から言うと、プログラム的にはマクロ変数と同じですが、プロセスフロー実行時に以下のようなウィンドウが出て、値を定義するように求められます。


これなら、値の設定を失念することもなくなりますし、お客様にEGPを提供する場合も負担が少なくてすみます。以下では期間抽出をプロンプトで行う方法を例に、プロンプトの定義方法をご紹介します。

以下のようなデータセットから、任意の年月の範囲をプロンプトで指定して、レコードを抽出してみましょう。


①クエリビルダからプロンプトマネージャを選択

 クエリビルダを開くと、プロンプトマネージャの項目があります。プロンプトマネージャを選択し、追加をクリックします。すると、プロンプト作成のウィンドウが出てきます。


プロンプトマネージャをクリック


追加を選択すると、プロンプトの作成画面が現れます。


②プロンプトの作成

 名前はわかりやすいものにしましょう。今回は年月を範囲指定して抽出するためのプロンプトを作成します。開始年月をSTART_YM、終了年月をEND_YMで作成します。

プロンプトにNULLを設定できないようにするには、「空白以外の値が必要」にチェックを入れます。


  「プロンプトの種類と値」のタブに移動すると、プロンプトの詳細定義が行えます。今回は数値変数に対する抽出を行う目的なので、「プロンプトの種類」は数値を選択します。また小数点以下は使用しないため、「整数値のみ許可する」にチェックを入れます。

最後に「最小値」、「最大値」を入力すれば、プロンプトの作成が完了します。


同様の手順でEND_YMも作成します。


③抽出条件にプロンプトを設定

 では、早速クエリビルダの抽出条件にプロンプトを使用してみましょう。変数「ym」に対して、演算子を「範囲内の値」します。
赤枠の部分をクリックすると、下記のようなウィンドウが表示されます。ウィンドウ内の「プロンプト」タブを選択すると、先ほど作成したプロンプトの一覧が表示されますので、「開始値」には「START_YM」、「終了値」には「END_YM」を選択します。

「開始値」、「終了値」の欄に直接「&START_YM」、「&END_YM」と直接入力しても構いません。


プログラムのプレビューを見ると、プロンプトが「&START_YM」、「&END_YM」になっており、内部的にはマクロ変数と同じ扱いになっていることがわかります。

では、クエリを実行しましょう。冒頭でご紹介した画面が出たので、値を入力します。2010年4月から2011年3月までのレコードを抽出してみましょう。

以下が実行結果です。

うまく抽出できています。
ちなみに、②でプロンプトにはNULL値を除外しているので、NULLを設定すると以下のようなエラーメッセージが表示されます。

後続の処理でプロンプトを使用する場合は以下の場所にチェックをいれましょう。


これによりプロセスフロー内で、プロンプトがマクロ変数として参照できるようになります。


2015年10月19日月曜日

SAS での回帰不連続デザイン (RDD) とビジネスでの応用について

2011年の米南東部 SAS ユーザー会 (SESUG) 発表資料で政策の効果を推定するための回帰不連続デザイン (RDD)を実行するマクロが紹介されている発表 Schoeneberger (2011) "RDPLOT: A SAS® MACRO for Generating Regression Discontinuity Plots" を見つけたので、
  1. RDD マクロの解説
  2. RDD そのものの解説
  3. ビジネスでの応用
をあわせて紹介したいと思います。かなりマニアックなテーマなので、「SAS にこじつけて自分の趣味の話をしたいだけだろ」と思われるかも知れません。おおむねその通りですがどうかご容赦ください。

RDDとは?

回帰不連続デザイン (RDD, Regression Discontinuity Design) というのは回帰分析の一種で、初め Thistlethwaite & Campbell (1960) "Regression-discontinuity analysis: An alternative to the ex post facto experiment" で発表されたものです。社会科学の研究では割りとポピュラーな手法ですが、日本語での情報はあまりありません。そのため, RDD の和訳も定着しておらず、切断回帰デザインとか非連続回帰計画というふうに呼ばれることもあります。例えば日本語ですと
  • アングリスト&ピスケ (2013) 『ほとんど無害な計量経済学 –応用経済学のための実証分析ガイド–』, 大森義明・田中隆一・野口晴子・小原美紀訳, NTT出版. 原著: Angrist, Joshua D. and Jrn-Steffen Pischke (2008) “Mostly Harmless Econometrics: An Empiricist’s companion,” Princeton University Press
  • 津川友介 (2015) 『回帰分断デザインRegression discontinuity design(および分割時系列デザイン)|医療政策学×医療経済学』
  • 森田果 (2014) 『実証分析入門 –データから「因果関係」を読み解く作法–』, 日本評論社
などで RDD が言及されています。より専門的な解説をした英語の論文は末尾の参考文献に挙げておきます。私は学生時代に、教育政策の効果を検証する方法として学びました。では、ビジネスの文脈、例えばマーケティングなどに応用されてはいないかと調べたところ、 Marketing Science 誌に掲載された論文で、RDD をマーケティング全般へ応用する方法について論じた Hartmann, Nair, & Narayanan (2011) "Identifying Causal Marketing Mix Effects Using a Regression Discontinuity Design" を見つけました。
上記の文献を読むだけでもなにを意図したものかおおむねわかるかと思いますが、この Hartmann らの論文に沿って簡単に解説したいと思います。
まず、ある政策を実施して、その効果がどれだけあったかを知りたいとします。 民間企業の立場なら、顧客に対するプロモーションを実施して、どの程度売上につながったか、とも解釈できます。どちらの想定でも、何らかの成果を期待してコストを払って施策を行っているわけなので、実際に効果があがっているかの検証は大事です。Hartmann et al. (2011) では、カジノでは少数の上客 (ハイローラー) が大きな利益をもたらしてくれることから、ハイローラーに対する優遇サービスを例に挙げていますが、 他の業種でのプロモーションの施策に置き換えて考えても問題ありません。単純に考えると、ハイローラーに対し優遇サービスを実施し、それ以外の利用客には実施しないとすると、
(効果) = (優遇を受けた利用客の平均) - (優遇を受けなかった利用客の平均)
というふうに優遇を受けた利用客と受けなかった利用客で分割し、それぞれのグループについて1人あたり売上額などを計算し、さらにその差をとれば、効果の大きさとみなせそうです。視覚的にあらわすならば、以下の図1のような棒グラフで表せます。
図1: 施策の有無と1人あたり売上額の差

ところが、実際は効果の大きさを正しく見積もるのは容易ではありません。2つのグループの利用客の傾向がかたよるからです。そもそも、カジノ側は、最初から多く遊んでくれるハイローラーに対してのみ優遇します。そのためハイローラーは、仮に施策を受けなかったとしても多く遊ぶ可能性が高いのです。逆に優遇を受けなかったグループは、優遇を受けたとしても商品を購入する可能性が比較的低いかもしれません。よって、ここで計算した差は、純粋な施策の効果だけでなく、偏った平均によるバイアスも含まれてしまい、過大に見積もってしまいます。同様の理屈で、逆にあまり遊ばない利用客に対して重点的に優遇を行った場合、効果が過少評価されるでしょう。
医薬品の臨床実験や、農作物の品種試験でも、薬品を投与した場合・しない場合や、新しい品種・既存の品種を比較して性能の差を見るのですが、このような偏りが起こらないようにコントロールするのが普通です (いわゆるランダム化)。 しかし、マーケティングに関しては利益に直結するため必ずしもこのコントロールができるとは限りません。
このように、偏りがある場合の対処方法として考案された方法が RDD です。 特に、この施策を受けるか受けないかの判断基準がしきい値 (これをカットオフ点ともいいます) で表現されるとき RDD が利用可能です。 ある数値を超えた人間が施策を受け、超えなかった人間は施策を受けないとします。
カジノの例でいうならば、利用客ごとの1日にカジノで使う金額を見て、一定額以上ならハイローラーに分類し、優待サービスを実施します。事実、ハイローラーに分類された利用客は1日あたりの使用金額が非常に多く、かつ来場回数も増えることが確認されています。利用客のハイローラーへの分類の前と後の利用金額の関係を擬似的に表すと、以下の図2のようになります。
図2: RDDの視覚的な説明

実際に効果があるのなら、中央のカットオフ点を境に、直線が断層のようにずれるはずです。この直線の、不連続な地点の上下のずれの大きさが、施策による効果の大きさとみなせます。
ここで、このカットオフ点の前後、たとえば前後1万円とすると、ハイローラーに分類されるかどうかに関係なく、適用前の利用客の使用金額にほとんど違いがありません。よって、この限られた範囲ならば、先に述べた偏りがほとんどないと考えられます。ここから、データから狭い範囲に属する利用客の情報だけを取り出して分析すれば、効果の大きさをうまく見積もることができる、というのが RDD の基本理念です。RDD は回帰分析を応用することでこのずれの大きさを計算し、そこから効果の大きさを推定します。

SAS での実行方法

冒頭で紹介した Schoeneberger (2011) で、 SAS マクロのすべてが公開されています。これは SAS/STAT SAS/GRAPH があれば実行可能なのでたいていの環境で実行できるのですが、 SAS University Edition では SAS/GRAPH がないため gplot プロシジャが使用できません。 そこで、 sgplot プロシジャで でグラフを描画するように書き換えたコードを使用します。このプログラムは記事の末尾に掲載しておきます。 元の regdis マクロはインプットデータを物理名で参照しますが、このままだと使い勝手が悪いので、 そのまま使う場合でも、元のプログラムも9ページ右上の最初のデータステップの
set "%bquote(&path)%bquote(&data_in)";
のところを
set &data_in;
に変えたほうが使いやすいと思います。
次に、以下のコードでインプットデータを作成します。
/*------------------------------
 RDD デモコード
 SAS/STAT が必要
-------------------------------*/

data param;
input _TYPE_$ _NAME_$ x_prior x_post;
cards;
COV x_prior 2 1 
COV x_post  1 3
;
run;

proc simnormal seed=1 numreal=100 data=param(type=cov) out=sample ;
    var x_prior x_post;
run;

data sample;
    call streaminit(1);
    set sample;
    x_prior+10;
    x_post +10;
    is_high=0;
    if x_prior >10 then do;
        x_post+rand('normal',4,.5);
        is_high=1;
    end;
run;
simnormal プロシジャというのは、与えられたパラメータから乱数を生成するプロシジャで、 SAS/STAT があれば使用可能です。これで2次元正規乱数を生成し、さらに加工することで擬似データを作成しています。乱数の種を固定しているので、毎回同じ結果になるはずです。データは各レコードが利用客の1人分の記録を表し、変数の x_prior が施策前の利用客の使用金額、 x_post が施策後の金額、 is_high が適用対象かどうかを表す変数です。
このデータを regdis マクロに入力します。私がデータセットの1行だけ改変したものですと、
%regdis(%str(),work.sample,x_prior,x_post,is_high,10,above,Y);
後で掲載する University Edition 対応版ですと
%regdis(work.sample,x_prior,x_post,is_high,10,above,Y);
を実行してください。以下は引数の解説です。
  1. path : ファイルのあるフォルダパスです。UniversityEdition版は廃止したため、次の data_in が第一引数になります。
  2. data_in: データセットのファイル名です。マクロを改変したので今回はデータセット名を書いています。
  3. pretest: 施策前の状態を表す変数です。X軸に当たります。
  4. posttest: 施策後の状態を表す変数です。Y軸に当たります。
  5. group: 各個人に対して施策がなされたかどうかの数値変数。適用対象なら 1、そうでなければ 0 です。
  6. cutscore: 適用対象を決めるしきい値 (カットオフ点)。今回は 10 とします。
  7. treat_loc: カットオフ点のどちら側が施策適用対象か。今回は 10 を越える利用客が対象なので、 above と入力します。逆は below です。
  8. plot_data: グラフにレコードの散布図を描くかどうか。 Y/N どちらかを入力します。 基本的に Y のほうが良いでしょう。
これを実施すると、 glm プロシジャで直線の傾きと切片が推定されるほか、結果のグラフが以下の図3のように表示されます (SAS University Edition の場合、使用しているスタイルによって結果が若干変わります)。
図3: 施策前後の使用金額の散布図と RDD による回帰直線の当てはめ

このマクロでは、直線回帰のみですが、仮説検定から2つのグループでそれぞれ傾きが異なると判定されたため、それぞれで傾きが異なっています。入力データによっては、両者の傾きが同じになる場合もあります。実際に RDD を使用する場合には、他のモデルと比較したり、使用するデータの範囲を決めたりといったことが必要です。

応用の可能性

Hartmann et al. (2011) ではさらに、いろいろな分野での応用の可能性を指摘しています. Table 6. にその一覧表があるので、和訳したものを掲載します。ここでのスコア変数というのは、上記のグラフの横軸に対応する変数です。一般には RDD は縦と横で異なる変数をとることができます。いずれの場合でも、スコア変数があるカットオフ点を超えた時に施策が行われるという例を示しているので、 RDD のフレームワークを用いて施策の有無と結果変数の差を見ることで、施策の効果の大きさがわかるということです。

SAS University Edition 対応版マクロ

/*---------------------------------------------------------------------
RDPlot macro program modified to use it in SAS University Edition
S-Katagiri, Nature Insight co., 24/Jun/2015
http://blog.n-insight.co.jp/

The original macro program is from
Schoeneberger, J. A. (2011).
RDPLOT: A SASR Macro for Generating Regression Discontinuity Plots. 
Proceedings of the annual Southeastern SAS Users Group Conference.
http://analytics.ncsu.edu/?page_id=3375
---------------------------------------------------------------------*/

**assumes data_in file is one line per unit-of-analysis record;
**assumes group is dichotomous, numeric variable coded 0=control, 1=treatment;
*data_in=the SAS dataset name for analysis;
*pretest=the pre-test score by which a cut-score being applied creates treatment-control groups;
*posttest=the posttest, dependent variable of interest;
*group=variable denoting treatment (1) or control (0) group membership;
*cutscore=numeric value on the pre-test that serves as the cut-score;
*treat_loc=denotes whether the treatment is above or below cut-score: insert 'above' or 'below' for this value;
*plot_data=denotes whether the user wants to plot actual data 'Y' or just RD lines 'N';

%macro regdis(data_in,pretest,posttest,group,cutscore,treat_loc,plotdata);
    data regdis;
        set &data_in.;
        ** homogeneity の検定のために相互効果の変数作成;
        interact=&group*&pretest;
    run;
    ** x, yの最小値最大値をマクロ変数に取得;
    proc sql noprint;
        select min(&pretest), max(&pretest), min(&posttest),
        max(&posttest)
        into: x_min, : x_max, : y_min, : y_max
        from regdis;
    quit;
    ** teart_loc に応じて補間点を並べる;
    %if "%upcase(&treat_loc)"="BELOW" %then %do;
        %let x_0=&x_max;
        %let x_1=&x_min;
    %end;
    %if "%upcase(&treat_loc)"="ABOVE" %then %do;
        %let x_0=&x_min;
        %let x_1=&x_max;
    %end;
    ** glmによる相互作用テスト (homogeneity assumption);
    ods output parameterestimates=paramsint;
    proc glm data=regdis namelen=32;
        model &posttest=&group interact &pretest/ss1
        solution;
        run;
    quit;
    ** homogeneity なら傾きを一定とする。そうでないなら個別に傾きを計算;
    data paramsint;
        set paramsint;
        if (parameter="interact") and (probt gt .05) then
            call symput('hetero','N');
        if (parameter="interact") and (probt le .05) then
            call symput('hetero','Y');
    run;
    ** 以下は傾き一定の場合 (hetero='N');
    %if "&hetero"="N" %then %do;
        ** 傾きを計算。;
        ods output parameterestimates=params;
        proc glm data=regdis namelen=32;
            model &posttest=&group &pretest/ss1 solution;
            run;
        quit;
        ** パラメータをマクロ変数に取得;
        proc sql noprint;
            select estimate into: intercept_g0
            from params
            where parameter="Intercept";
            select estimate into: grp_slp
            from params
            where parameter=lowcase("&group");
            select estimate into: cut_slp_g0
            from params
            where parameter=lowcase("&pretest");
        quit;
        %let intercept_g1=%sysevalf(&intercept_g0+&grp_slp);
        %let cut_slp_g1  =&cut_slp_g0;

    %end;
    ** 以下 homogeneity ではない場合 (hetero='Y');
    %if "&hetero"="Y" %then %do;
        ** 以下の glm で2つのグループの回帰係数を別々に推定;
        ods output parameterestimates=paramsg1;
        ** treatment グループの係数;
        proc glm data=regdis;
            model &posttest=&pretest/ss1 solution;
            where (&group=1);
            run;
            quit;
        ods output parameterestimates=paramsg0;
        ** control グループの係数;
        proc glm data=regdis;
            model &posttest=&pretest/ss1 solution;
            where (&group=0);
            run;
        quit;
        ** sql プロシジャでパラメータを取得;
        proc sql noprint;
            select estimate into: intercept_g1
            from paramsg1
            where parameter="Intercept";
            select estimate into: cut_slp_g1
            from paramsg1
            where parameter=lowcase("&pretest");
            select estimate into: intercept_g0
            from paramsg0
            where parameter="Intercept";
            select estimate into: cut_slp_g0
            from paramsg0
            where parameter=lowcase("&pretest");
        quit;
    %end;
    ** 以下、共通処理;

    ** 回帰直線の点を追加;
    data regdis2;
        set regdis end=eof;
        output;
        if eof then do;
            %do i=0% to 1;
                x=&&x_&i;
                y=&&intercept_g&i + &&cut_slp_g&i* &&x_&i;
                &group=&i;
                output;
                x=&cutscore;
                y=&&intercept_g&i + &&cut_slp_g&i* &cutscore;
                &group=&i;
                output;
            %end;
        end;
    run;
    data regdis2;
        set regdis2;
        if &group=1 then group='treatment';
        else group='control';
    run;
    ** スタイルの定義;
    proc template;
    define style Styles.rdplot;
        parent = Styles.Listing;
        style GraphData1 from GraphData1 / 
            markersymbol = "circle"
            color = blue 
            ;
        style GraphData2 from GraphData2 / 
            markersymbol = "triangle"
            color = red 
            ;
        end;
    run;
    ** グラフ出力;
    ods html path='/folders/myfolders' file='rdplot.html' style=Styles.Rdplot;    
    ** グラフ描画;
    proc sgplot data=regdis2;
            refline &cutscore / axis=x;
            scatter x=&pretest y=&posttest /name='plot' group=group %if "%upcase(&plotdata)"="N" %then markerattrs=(size=0);;
            series x=x y=y /group=group;
            xaxis label="pretest"  minor;
            yaxis label="posttest" minor;
            keylegend 'plot' /noborder across=2 title='Intervention Group';
    run;
    quit;
    ods html close;

%mend regdis;

参考文献

Hahn, J., Todd, P., & Van der Klaauw, W. (2001). Identification and Estimation of Treatment Effects with a Regression-Discontinuity Design. Econometrica, 69(1), 201–209. doi:10.1111/1468-0262.00183
Hartmann, W., Nair, H. S., & Narayanan, S. (2011). Identifying Causal Marketing Mix Effects Using a Regression Discontinuity Design. Marketing Science. doi:10.1287/mksc.1110.0670
Imbens, G. W., & Kalyanaraman, K. (2012). Optimal Bandwidth Choice for the Regression Discontinuity Estimator. Review of Economic Studies, 79(3), 933–959. doi:10.1093/restud/rdr043
Imbens, G. W., & Lemieux, T. (2008). Regression discontinuity designs: A guide to practice. Journal of Econometrics, 142(2), 615–635. doi:10.1016/j.jeconom.2007.05.001
Lee, D. S. (2008). Randomized experiments from non-random selection in U.S. House elections. Journal of Econometrics, 142(2), 675–697. doi:10.1016/j.jeconom.2007.05.004
McCrary, J. (2008). Manipulation of the running variable in the regression discontinuity design: A density test. Journal of Econometrics, 142(2), 698–714. doi:10.1016/j.jeconom.2007.05.005
Schoeneberger, J. (2011). RDPLOT: A SAS® MACRO for Generating Regression Discontinuity Plots. In SESUG Proceedings 2011. URL: http://analytics.ncsu.edu/?page_id=3375
Thistlethwaite, D. L., & Campbell, D. T. (1960). Regression-discontinuity analysis: An alternative to the ex post facto experiment. Journal of Educational Psychology. doi:10.1037/h0044319
2015/7/3 片桐

2015年10月14日水曜日

無料で SAS を使ってみよう 3: ETS が使えるようになった SAS OnDemand

概要

これまで、仮想環境、Amazon Web Service (以下、AWS) などで 無料版である SAS® University Edition を提供してきた SAS Institute 社ですが、第1弾の SAS Universiry Edition のライセンスが切れるこの時期になって、SAS OnDemand for Academicsを繰り出してきました。これまでとの大きな違いは以下の2点に集約されます。
  • 導入が非常に簡単。 仮想化ソフトのインストールや AWS の登録も不要です。SAS社の公式サイトでユーザー登録すれば、あとはブラウザ上で動きます。
  • SAS/ETS®, Enterprise Miner™ (EM), Enterprise Guide® (EG), Forecasting Server も使えるようになりました。 これまでの無料版では基本的なパッケージしか使えませんでしたが、今回はより高度な分析手法を提供してくれる Econometrics and Time Series Software (ETS) や EM 等も利用可能です。SAS EG も SAS のコーディングを意識しなくても GUI の操作だけでデータの加工ができる手軽さから、導入している企業も多いかと思います。特に今回は、SAS OnDemand の導入方法だけでなく、SAS/ETS の使い方の例を1つ紹介しておきます。

導入方法

それでは導入方法を紹介します。と言っても今まで (http://blog.n-insight.co.jp/2014/09/sas.html) よりもさらに簡単なのでほとんど書くことはありません。規約についても、私が見た限りでは University Edition の頃とあまり変わってないようです。
では実際に導入してみましょう。日本語版ページは ここにありますが、8月31日現在詳しいマニュアルは英語のみです。http://support.sas.com/ondemand/steps.html
唯一やるべきことは、ブラウザを開き、公式サイトでユーザ登録をすることです。
ブラウザは IE・FireFox・Google Chrome・Safari など主要なものはすべて使えます。 すでに SAS University Edition の登録を済ませていた場合でも登録が必要ですが、登録済み場合は新しいライセンスに同意するかどうかを入力するだけで登録が完了します (ID・パスワードは以前のものをそのまま使用できます)。
このような画面が出ます。まずは下方の 「Register for an account」をクリックしてユーザ登録をします。これ以降、すべて英語ですが、難しいことはなく、名前等を流れで記入するだけです。
登録が完了し、先ほどのサインイン画面に戻ってログインすると以下のような画面になります。
ここで、青字の 「SAS® Studio」をクリックすれば早くも SAS を起動できます。なお、下の「Courses I teach (create a new course)」 という項目は、今回から提供された、大学教員向けのSASを使った教育プログラム作成機能で,SAS Enterprise Miner 等を利用したい場合もここから新しい授業コースを作成するという形で利用できますが、これの説明は別の機会にしたいと思います。
あとはいつもの SAS Studio の画面です。

SAS/ETS® について

以下は、SAS/ETS の紹介です。やや専門的な話題なので、単に SAS OnDemand の導入をしたいだけの場合、読み飛ばしても問題ありません。また、計量経済学の知識があるか、すでに『その回帰分析、本当に因果関係ありますか? - 操作変数法の話 -』を読んでいた方向けです。
SAS ETS とは、計量経済学 (econometrics) や時系列 (time series) 分析を行うためのプロシジャを提供してくれるパッケージです。たとえば、以前 『その回帰分析、本当に因果関係ありますか? - 操作変数法の話 -』というタイトルで記事を書きましたが、2段階最小二乗法を実装するため、REG プロシジャを2回繰り返して実行しました。一方 ETS では、SYSLIN プロシジャを使えば 1回のプロシジャで実行できます (SYSLIN プロシジャの公式リファレンスはこちらです)。
ただし、SAS OnDemand ではデータセットを先にアップロードする必要があります。左側のファイラで、「ファイル (ホーム)」 を右クリックして「ファイルのアップロード」を選び、ファイルをアップロードしてください。今回はデータセットに https://ideas.repec.org/p/boc/bocins/griliches76.html からダウンロードした .dta ファイルをインポートしています。これをインポートし、前回と同様の分析をするプログラムが以下です。
/* .dta形式のデータセットを読み込む*/
proc import datafile='/home/ここにユーザー名/griliches76.dta'
    out=work.grilic
    dbms=dta replace;
run;
data work.grilic;
    set work.grilic;
    y_67 = (year=67);
    y_68 = (year=68);
    y_69 = (year=69);
    y_70 = (year=70);
    y_71 = (year=71);
    y_72 = (year=72);
    y_73 = (year=73);
run;
proc syslin data=work.grilic 2sls;
    endogenous  S IQ;
    instruments EXPR TENURE RNS SMSA y_: MED KWW AGE;
    wage_function: model LW = S IQ EXPR TENURE RNS SMSA y_: /overid ;
run;
SYSLIN プロシジャは REG プロシジャとは構文が異なります。ENDOGENOUS 文は、「内生」変数を記入するところです。内生変数、つまり外部からの影響を受ける可能性のある変数は、教育を受けた年数 (S) と 知能指数 (IQ) でしたので、この2つを入力します (厳密には、左辺の被説明変数 (LW) も内生変数と呼ばれるので、「被説明変数いがいの内生変数」を列挙します)。
次に、 INSTRUMENTS 文は、操作変数のリストです。残りの説明変数と、新たに加える操作変数のリストです。これは以前のやり方における、1段階目の REG のモデルの説明変数と同じです。
最後に、 MODEL 文にモデルを記入します。以前のやり方での2段階目の REG のモデルに相当します。以前は Shat, IQhat という変数名を使用していましたが、今回は1段階目の計算を自動で実行してくれるので、単に model LW = S IQ ... ; と書きます。 また、スラッシュのあとのオプション overid は、過剰識別の検定を行います。前回は Sargan 検定でしたが、overid オプションでは Basmann による方法で、若干計算方法が異なります。

これで2段階最小二乗法を計算した結果、係数は前回とほぼ同じ数値が出ました。さらに、Basmann 検定も、帰無仮説を棄却できていません。Basmann 検定も Sargan 検定も、帰無仮説の棄却は操作変数が正しく選ばれていないことを意味します。

2015/09/02 片桐

2015年10月2日金曜日

SASとMySQLにおける「null値」の扱い方の違いによる問題


以前に携わった案件でRDBMSとしてMySQLを使い、帳票作成やデータの更新処理はSASを通して行うシステムの開発がありました。

その際に、SASとMySQLにおける「null値」の扱い方の違いで苦しめられたことがあったので、自分の備忘録も兼ねて書いておこうと思います。

まず、SASには【In-Datebase】というサービスがあります。
これがどういったものかざっくり説明すると
『DB側で処理できる処理はDB側で処理してもらっちゃおう!』
というものです。名前のまんまですね。

パススルーを用いてSQL文を直接DB側に投げて処理させることもできるのですが、この【In-Database】のすごいところは
『SASのコードで書いた処理でも、DB側で処理した方が良い処理は、自動変換してDB側で処理させちゃう!』
ところです。賢いですね!

ただ今回の件は、この賢さが故に起きてしまった問題なのですが・・・


それでは前置きはこのくらいにして、今回起きた問題について書いていこうと思います。

例えば、以下に示すようなデータがMySQL上に存在したとします。

テーブル名「sample」
スキーマに割り当てたライブラリ参照名「db」
※四郎さんの郵便番号は「ブランク」、五郎さんの郵便番号は「null値」


上記データを「郵便番号」・「年齢」の昇順でソートしたデータをSASのワーク領域に抽出したい場合

  proc sort data = db.sample
                out  = work.sample ;
    by post_no age ;
  run ;

となります。

なんの変哲もないただのソート文なのですが・・・
SASは「null値」と「ブランク」は同じ文字値の欠損値として扱うのに対し
DB上では「null値」と「ブランク」は別のものとして扱うため
上記のソート文を実行した時に作成される「work.sample」は
【In-Database】で処理を行った場合とそうでない場合で以下のような違いが生まれます。

【In-Database】で処理していない場合


【In-Database】で処理した場合


抽出後のデータはSASデータセットなので、「null値」は「ブランク」に変換されます。
そして、注目していただきたいのは四郎さんと五郎さんの並びです!

【In-Database】を用いない場合は、DBからデータをSAS側に抽出してからソートを行うため、ソートの段階で「null値」と「ブランク」の区別はありません。

そのため、四郎さんと五郎さんの「郵便番号」は同一となり、第2ソートキーの「年齢」によって昇順にソートされます。

これに対して、【In-Database】を用いた場合は、先ほどのソートはDB側で行われて、ソートした状態のデータをSAS側に送ります。

DB側では「null値」と「ブランク」は区別され、「null値」は「ブランク」よりも更に小さい値として処理されてしまうため、五郎さんの方が、昇順で上にきてしまいます。


さて、ソート順くらい。。。と思う方もいらっしゃるかと思うのですが、、、
ここで問題発生です!!!

上記の【In-Database】を用いてソートを行ったはずのデータセットですが、並び順が本来SASでソートした順番とは違うため、DATAステップ等でグループ処理を行おうとすると、もちろんエラーになります。

つまり、以下のプログラムを【In-Database】のサービスを利用している状況下で実行するとエラーになります。

  proc sort data = db.sample
                out  = work.sample ;
    by post_no age ;
  run ;

  data work.test ;
    set work.sample ;
    by post_no age ;
    if first.age = 1 then output ;
  run ;

ログには『「work.sample」はちゃんとソートされていません。』的なログが出ます。
目の前でソートしてるのに・・・


対処法としては、「null値」と「ブランク」が混在する可能性があるデータの場合、ソート処理の前にSASデータセットとして抽出してから処理を行うことです。

もっとそもそもな方法としては
『テーブルを作成する段階で制約を設けて「null値」で登録できないようにすること』
もしくは
『「null値」と「ブランク」が混在しないようなシステムにすること』
になります。

DBのテーブル定義は思ったより奥が深く、本当に色んなことができます。
DBをただのデータの入れ物にしないように、これからも勉強を続けていきたいです。

ちなみに今回の「null値、ブランク」問題は単純なデータ抽出(where句等で)を行う際にも立ちはだかるようです。
便利なサービスも使いこなしてこそですね。

2015年9月18日金曜日

無料で SAS を使ってみよう2〜アマゾンウェブサービス編〜

以前、こちらで導入方法を紹介しました SAS® University Edition ですが、クラウドサービスであるアマゾンウェブサービス (AWS) からも利用できるようになりました (公式サイト)。 そこで、AWS版の導入方法について紹介したいと思います。

従来版とAWS版の違い

SAS® を試してみたいけどどっちを使えばいいかわからないという方、もしくは従来版をすでに使っていて、AWS版はどう違うんだ、という人のために先に特徴を簡単にまとめておきます。
  • 従来版
    • ローカルで作業できる
    • 無料
    • 仮想マシンのインストールや設定作業が面倒
  • AWS版
    • インストールが必要ない
    • やや速い?
    • SAS自体は無料だが1年後からAWSの利用料金が発生する場合がある
    • アマゾンウェブサービスのアカウント作成と設定が必要
SAS® University Edition 自体は従来版、AWS版いずれも無償ですが、アマゾンウェブサービス自体のシステムとして、アカウント登録から1年以内ならば条件つきで無料、それ以降は月額料金がかかる、というシステムなので注意が必要です1。
AWS 版 SAS® University Edition の利用規約も英語ですが、直接利益を得るような使用はだめで、あくまで学習・学術用途に限ることとか、プログラムの逆解析や無断再配布といった著作権侵害行為をしてはならない、とか 18歳未満の方は保護者の同意のもとで使用すること、といった従来版とだいたい同じで常識的な内容です2が、Webサービスなので、次のような追加の条件があります.
  1. SAS Institute社の製品開発・品質向上のためソフトの使用に関する匿名の情報送信に協力すること。
  2. 個人で利用すること. 複数人で利用してはならない. また、第3者による不正なアクセスをされないようにする。
  3. プログラムやドキュメントをローカルにコピーしてはならない。
(1) は最近のWebサービスではよくある条項ですが、個人情報を送信されるのが気になるという方もいるかもしれませんのでご注意ください。 (2) は、クラウドサービスですがあくまで個人の学習用なので、グループでの利用はできないようです。

導入方法

アマゾンウェブサービスのアカウント作成ができたら、SAS社公式サポートページ "How do I run SAS University Edition on Amazon Web Services Marketplace?" を参考に SASを起動します。現時点では SAS社のサポートページも、マーケットプレイスも英語のページしかないので、日本語で簡単に説明しておきます。
まず、アマゾンウェブサービスのマーケットプレイス (いつもの通販サイトとして利用しているサイトではありません!) にて、sas university edition を探します。このページの一番下に利用規約 (End User License Agreement) があります。同意できるのなら、ページ右上の Continue をクリックします (ここまで英語ページの1.、2. に相当します)。 Continue ボタンの下にリージョン選択がありますが、これは何でもいいようです。
3. 次に SAS® University Edition の設定を行います。 (1) 1-Click Launch タブを選択していることを確認し、(2) EC2 Instance Type は t2.micro を選択します (他のを選ぶこともできますが、その場合アマゾンウェブサービス1年間無料枠の適用外なので料金が発生します。)。
(3) 一番下のKey Pair は設定せずに、左上の “Accept Terms & Run 1-Click” をクリックします。
4. いよいよ起動です。 画面右上の ``‘Your Account’’ をクリックし、移動先ページの “manage your woftware subscription” をクリックします。
すると、一覧に SAS University Edition のインスタンスが作成されています。ここで画像の黒塗りの部分にインスタンスIDが表示されます。 これはログインパスワードになるので、規約に従って隠しています。これはコピーしておきましょう。 右側の “Access Software” をクリックします。ダイアログボックスが現れ、ユーザIDとパスワードを訊かれるので、ユーザIDに “sasdemo” パスワードにさきほどコピーしたインスタンスID を入力します。
ログインに成功すると、従来版と同じようなスタート画面が表示されます。「お知らせ」欄にアップデートの通知が来てるときは適宜更新しましょう。初回はたぶん更新通知が来ていると思います。
「SAS Studio を始める」をクリックすれば SAS を利用できます。
ダウンロードとインストール作業がないぶん, 従来版より時間はかかりませんが, アマゾンウェブサービスの無料利用は1年だけなので留意ください。

AWS版利用の際の Tips

インスタンス終了・再開の方法

1年間無料の場合, t2.micro インスタンスは月750時間まで無料なので, 実行する必要は少なそうですが, インスタンスの停止・再起動についても補足説明しておきます。 SAS Studio をログアウトした後、マーケットプレイスの “manage your woftware subscription” から “manage in AWS Console” をクリックし、アマゾンウェブサービスのEC2管理コンソールへ移動します。 左のタブから「インスタンス」をクリックし、SAS® University Edition のインスタンスを選択し、右クリックメニューもしくは「アクション」から、「インスタンスの状態」を選び、「停止」・「再起動」を選択します。「削除」を選んだ場合、インスタンスが削除されるので、永久ライブラリに保存したデータセットなども削除されます。なお、インスタンスはリージョンごとに表示されるので、起動したはずなのに一覧にない、という場合はリージョンが違う可能性があります。リージョンは右上で変更できます。

フォルダの扱い

AWS版 SAS University Edition はアマゾンウェブサービスのサーバ上で動かしているため、自分のパソコンにあるファイルを直接開くことはできません。画面左のアイコンをクリックすればアップロードが可能です。
ファイルやライブラリのパスを指定するときは、従来版と同じように /folders/myfolders/ その配下にアップデートしたファイルや、作成したフォルダを指定します。
以下は、“Hello,SAS!” とだけ書いた test.txt というファイルをアップデートし、それを読み込んでログに表示させるプログラムの実行結果です。

新機能・ビジュアルプログラミングについて

AWS版でも従来版でも最新のものにアップデートすればできるのですが、「ビジュアルプログラマ」という新機能が追加されました。プログラムを処理ごとに分割してフローチャート図のように表すことで、流れをわかりやすくしたり編集をしやすくしたりできます。画面右上の「SASプログラマ」をクリックして「ビジュアルプログラマ」を選ぶと以下のような画面になります。
フロー画面

クエリ作成画面

ビジュアルプログラミングは左上の + マークを押せば新しくユニットを作成できます。プログラム・クエリ・サブフローが選べます。クエリは SQL クエリのようにデータセットの結合・ソート・フィルタなどができます。この機能は SAS® Enterprise Guide (公式サイト 、略称 EG) という製品に似ています。 SAS® EG はクエリ以外にも、さまざまなグラフを作成したり回帰分析や多変量解析、時系列分析などの分析を実施したり、それらをレポーティングしたりといったことを、プログラムをあまり意識せずに実行することができます。

  1. アマゾンウェブサービス上でSAS の利用に必要なサービスは Amazon EC2 という仮想サーバを提供するサービスです。これは t2.micro インスタンス (仮想サーバ) の使用を月750時間以内におさえている限り無料です 。ただしこれは現時点のものですので、登録前に必ずアマゾンウェブサービスのサイト『AWS クラウド 無料利用枠』や『AWS 無料利用枠提供規約』などで利用枠の詳細をご自身でご確認ください。↩
  2. 2015年5月22日現在、英語のみですが、将来的に公式日本語版規約が公表されるかも知れません. またここでの概要はあくまで記事執筆者である私の個人的解釈ですので、規約の同意は自己責任でお願いします.↩

2015年5月1日金曜日

説明力のある回帰分析モデルは使えない?

・株価の動きを説明する回帰モデルを作れば株で儲けられるのでは?

今回も回帰分析の話をします。例として、日経平均株価について回帰分析をして株価予測モデルを作ってみましょう。日経平均株価は「日経平均プロフィル」の以下のページから csv ファイルをダウンロードしました
http://indexes.nikkei.co.jp/nkave/index
この csv ファイルをSASに読み込みます。ただし、以下のプログラムでは、読み込んだデータセットを半分に分けています。これは、前半のデータでモデルを推定し、後半のデータで、推定したモデルを使って擬似的に株価予測をするためです。
/* パスは適宜変更してください */
%let csvpath=C:\Users\HOGEHOGE\Downloads\nikkei_stock_average_daily_jp.csv;
libname tmp "C:\Users\HOGEHOGE\Documents";
data work.stock;
    attrib  date  length=8 label='経過日数'          
    end   length=8 label='終値'
    start length=8 label='始値'
    high  length=8 label='高値'
    low   length=8 label='安値'
    _date_ length=8 label='日付' format=yymmdds10.        ;
    infile "&csvpath." dsd firstobs=2;
    input date: yymmdd10. end start high low;
    _date_=date;
    date = date- '03Jan2012'd;
run;
data work.stock_1 work.stock_2;
    set work.stock;
    /* 2013年8月14日で分割 */
    if _N_ <= 400 then output work.stock_1;
    else                output work.stock_2; run; 
日毎の株価終値の折れ線グラフが以下のようになります。
日々の上がり下がりはあるものの、全体として右上がりの傾向があります。そこで、経過日数を説明変数にして回帰してみましょう。このようなモデルです。
左辺の yt は株価終値を、右辺の t は経過日数を表し、 εt
は誤差を表します。先ほど分割したデータのうち、前半のデータを使い、reg プロシジャで計算します。
proc reg data=work.stock_1;
    NIKKEI:model end = date;
quit; 
結果が以下です。
係数が有意で、決定係数の値も 0.70 とかなり高めです。株価終値の実際の値と回帰直線をグラフにすると、こうなります (グラフはプロシジャ実行時に自動で作成されます)。
しかし、線形回帰モデルはつまり、データの特徴を直線で表現しようというものです。直線からはずれた大きな上下の波を説明することはできません。直線と実際の株価とで1000円単位の誤差があるのでは、実用に問題がありますね。

・多項式モデルなら株価の動きをかなり正確に説明できる

では、直線でなく曲線で回帰してみましょう。つまり、
というふうに経過日数の多項式にすれば上下に波のある株価の動きを表現できるはずです。 t2, t3, ... と続く t のべき乗を、t とは個別の説明変数と考えれば、これは実質的に重回帰と同じなので、最小二乗法で計算できます。まずは3次式
で回帰してみましょう。ここで、毎回コードを書くのは面倒なので、任意の次数の多項式で回帰するためのマクロを用意します。
%macro poly_reg(d=2);
    /* べき乗を計算*/
    data work.stock_1
         work.stock_2;
        set work.stock;
        %do i=1 %to &d.;
            date_&i. = date**&i.;
        %end;
        if _N_ <= 400 then output work.stock_1;
        else                output work.stock_2;
    run;
    /* 最小二乗法で推定*/
    proc reg data=work.stock_1
             outest=work.result_est;
        poly_&d.: model end = date_1-date_&d. ;
        output out=tmp.stock_1_est p=predict;
    quit;
    /* 外挿 */
    proc score data=work.stock_2
         score=work.result_est
         out  =work.temp(rename=(poly_&d.=predict))
         type=parms;
        var date_1-date_&d.;
    run;
    data tmp.stock_1_est_&d.;
        attrib  predict label='終値の予測値';
        set tmp.stock_1_est(keep=_date_ end predict);
    run;
    data tmp.stock_est_&d.;
        attrib  predict label='終値の予測値';
        set tmp.stock_1_est_&d.
            work.temp(keep=_date_ end predict);
    run;
%mend; 
このマクロではまず、次数に応じて経過日数の日付のべき乗の変数を作り、 reg プロシジャで回帰し、さらに score プロシジャを用いて、回帰に使わなかったほうのデータに対しても、推定結果から予測値を計算しています。大雑把ですが score プロシジャの構文の解説をすると,
proc score data=予測値を計算したいデータセット
           score=推定した結果(係数)の入っているデータセット
           out  =予測値の結果出力先データセット
           type =parms;
    var モデルの説明変数名の列挙;
run;
というふうになります。よって今回は data= に期間外のデータ work.stock_2 を、 score= には直前の reg プロシジャの推定結果を与えています。 type= は score= で指定した入力データセットが何なのかを指定しています. 今回は係数 (パラメータ) を格納したデータセットなので、type=parms と指定しています。このように、推定したモデルを期間外 ―つまりたいていは分析の後に得られた未来のデータ― に対して適用し、予測値を計算することを外挿または補外 (extrapolation) といいます。 予測値の計算だけをするので、外挿に必要なのは右辺の説明変数だけです。
ちなみに、今回は使いませんが、ロジスティック回帰をする場合なら、 logistic プロシジャ内で scoreステートメントを使うことで外挿ができるので、 score プロシジャは不要です。それ以外の回帰分析では、この score プロシジャを使います。
これで、 %poly_reg(d=); とするだけで、任意の次数の多項式で回帰分析してくれます。
重回帰分析になると、自動で当てはめプロットをしてくれないので自分でグラフを作る必要があります。
決定係数の値が大きくなっているため、「当てはまりの良さ」言い換えるなら説明力が向上しています。プロット図からも、
と、前よりも実際の株価の推移に近づいているように見えます。では、もっと多項式の次数を増やせばさらに近づくのでは無いでしょうか?
%poly_reg(d=5);
%poly_reg(d=8);
として、5次多項式と8次多項式についても回帰してみましょう。
5次多項式
8次多項式
5次、8次と次数を増やしていくほど、曲線が実際の株価の推移に近づいています。当てはまりの良さの指標である決定係数も増加しています。これは株で儲けるチャンスでは?

・過去の株価では取引できない

しかしこれで儲ける前に、予測結果についても見てみましょう。この回帰モデルは過去 (2012年1月4日から2013年8月14日) の株価データを使って作成しました。現在分かってる部分だけでなく将来の株価の動きも説明できなければ儲けることはできません。もちろん未来の株価が実際にどうなるかを知ることができません。そこで回帰分析の計算に使った期間より後のデータ (2013年8月15日から2015年4月)を使って、予測値と実績値の比較をすることで、擬似的に未来の株価を予測できているかを確認します。最初に株価のデータセットを2分割したのはこのためです。
まずは 3次式の予測結果...
当てはまっているようにも見えますが、やはり急激な動きには反応してませんし、後半の時期はだいぶ実績値から離れていますし、期間の端では曲線が逆方向へ伸びています。では、5次、8次多項式ではどうでしょうか。3次多項式より当てはまっていたので、もっとよく予測できるはず……
……ん? おかしいですね……、大きく下へ外れています。たまたま調子が悪かったのかもしれません。8次多項式のほうはどうでしょうか?
予測値が上へ大きく伸びているので、本来の株価の推移が平たく潰れてしまっています。予測としてまったく用をなしません。

・木を見て森を見ず

種明かしをすると、これは過剰適合 (overfitting) という現象です。機械学習の分野では過学習 (overlearning) とも呼ばれます。推定に用いるのは限られた期間のデータなので、このデータだけにモデルをぴったり合わせようとすると、この期間にたまたま起こったノイズ的な事象にまで合わせようとしてしまい、結果としてそれ以外の期間の予測精度が悪くなります。長期間ある株価の動きのうちの一部の限られた部分だけを見て、都合のよい解釈をしてしまっている、まさに「木を見て森を見ず」という状態です。
もうひとつ、過剰適合が問題だと直感的にわかる例を挙げます。さいころを6回振って、2の目がたまたま3回出たとします。では、この事実からさいころの2の目が出る確率が1/2だと言えるでしょうか?
ましてや株価の動きは、さいころを振ってどの面が上を向くか、という現象よりはるかに複雑な現象です。このさいころの例のような明らかな誤解も、複雑すぎる問題のなかでは誤解であると気づけないことが多々あります。
今回これらのモデルは、モデルの当てはまりの良さの指標である決定係数がかなり高かったのですが、このように、決定係数が高い=予測性能が高い、ではないことが分かります。一般に、説明変数が増えるほど過剰適合が起こりやすくなります。今回の場合、むやみに次数を増やすことで説明変数が増えていました。当てはまりの良さだけを考えて回帰分析するのは非常に危険です。
では、どうすれば過剰適合を回避できるのでしょうか。いくつか方法があります。
  1. 今回のように、データを係数の推定用と外挿用に分割する。外挿結果があまりに実績値と外れていれば、そのモデルは過剰適合である、ということが分かります。この方法は実際には今回のようにグラフを確認するだけでなく、より厳密で複雑な手続きがあり、「交叉検証法(クロス・バリデーション)」と呼ばれます。
  2. 「情報量規準 (information criterion)」を用いる。これは複数のモデルの候補があって、最終的にどれが一番予測性能があるか (=過剰適合が少ないか) を選ぶときに使用できます。モデルの当てはまりの良さを表す指標に対して、説明変数の数に応じて減点して求めた指標「情報量規準 」を用います。
  3. 「調整済み R2 乗」を使う。 reg プロシジャの結果にある「調整済み R2 乗」というのは、この過剰適合に対応した決定係数で、過剰適合があってもあまり値が大きくならないよう、通常の決定係数とは計算方法を変えています。しかし今回のように、過剰適合があっても値が大きくなることもよくあるので、絶対ではありません。そのため、上記2つに比べると、これはあくまで目安です。
最後に重要なのですが、過剰適合というのは、「モデルを説明しない」変数をむやみに追加することで発生します。つまり、過剰適合のあるモデルとは、適当な数字を説明変数として詰め込んで作られたハリボテのようなものです。というわけで、今回の株価予測モデルは、実際には意味のない説明変数を使って説明したように見せかけただけですので、これで儲けることはできません (身も蓋もないですが、そもそもそんなモデルを発見しても誰にも言いません)。過剰適合を回避するとは、無意味な説明変数を切り捨て、本質的な法則性を表す説明変数だけを残すようにモデルを洗練するということです。

・まとめ

  • 分析に使えるデータは常に、全体の限られたごく一部。
  • 限られたデータだけを説明しようとすると「木を見て森を見ず」状態になる (過剰適合)。
  • 過剰適合を回避する方法がある。
  • 重要なのは、背後に隠されたメカニズムを意識してモデルを作ること

・おまけ

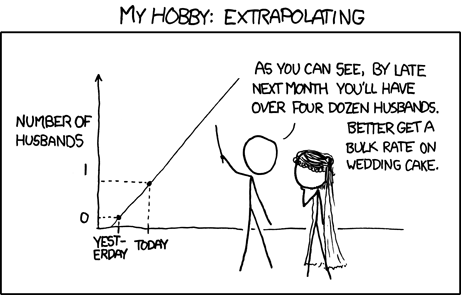
xkcd というサイトに掲載されている、無茶な設定の予測モデルに関する漫画です。今回の話のように、限られたデータだけしか見ないで、背後の因果関係を無視していることを笑いの種にしています。
「グラフを見てわかるように、翌月には夫が40人を超えます。ウェディングケーキをまとめ買いするといいでしょう」
「グラフを見てわかるように、翌月には夫の数が大きなマイナスになります。全員分 (マイナス個) のウェディングケーキを買えば儲かるでしょう」
上記画像は xkcd により、 クリエイティブ・コモンズ 表示 - 非営利 2.5 一般 ライセンスの下に提供されています

ネイチャーインサイト サイトリニューアル&NIBLOGの引っ越し

ご連絡が遅くなりましたが、 ネイチャーインサイトの際とがリニューアルしました。 https://www.n-insight.co.jp/ それに伴い、NIBLOGも引っ越しすることになりました。 https://www.n-insight.co.jp/niblog/ ...